Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning
Sanchit Sinha, Guangzhi Xiong, Bohan Liu, Zhenghao He, Aidong Zhang
Resumen
Resumen traducido automaticamente a partir del original en ingles.
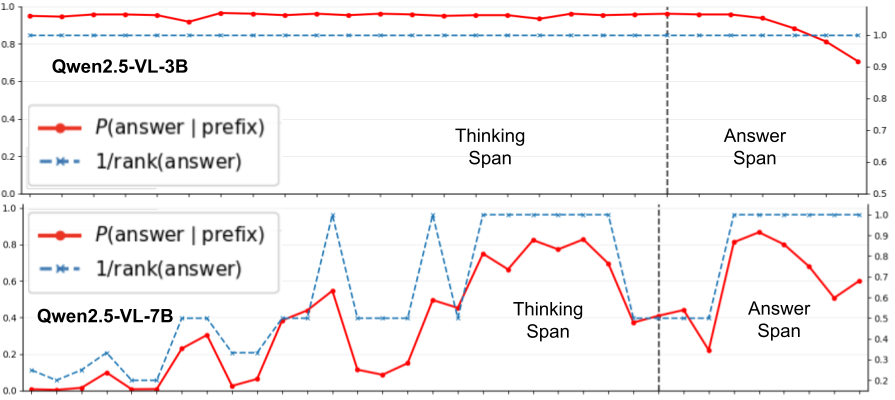
La eficacia del prompting con cadena de pensamiento (CoT) en los grandes modelos de lenguaje multimodales (MLLM) sigue siendo incierta: en varios benchmarks de razonamiento visual, el prompting CoT a menudo degrada el rendimiento en comparación con el prompting directo. En este artículo proporcionamos un análisis sistemático del comportamiento CoT en tres familias modernas de MLLM a distintas escalas, sobre conjuntos de datos que requieren evidencia visual por pasos. Nuestro análisis identifica dos modos de fallo recurrentes: el compromiso prematuro con la respuesta y el acceso limitado a tokens visuales directos durante la generación de la justificación. Además, encontramos que el ajuste fino supervisado estilo CoT estándar (CoT-SFT) mitiga estos problemas solo parcialmente, mientras que a menudo aumenta la dependencia de los priores textuales y reduce la dependencia visual contrafactual. Motivados por estos hallazgos, proponemos Attentive-CoT (Att-CoT), un objetivo de ajuste fino guiado por atención que anima a las trayectorias CoT a retrasar el compromiso con la respuesta manteniendo un acceso sostenido a los tokens visuales. Att-CoT puede integrarse en cualquier entrenamiento CoT-SFT sin cambios arquitectónicos. Experimentos en tres benchmarks de razonamiento visual y seis MLLM muestran que Att-CoT mejora el rendimiento CoT sobre el ajuste fino estándar.
Resumen original (ingles)
The effectiveness of Chain-of-Thought (CoT) prompting in Multimodal Large Language Models (MLLMs) remains uncertain: across several visual reasoning benchmarks, CoT prompting often degrades performance compared to direct prompting. In this paper, we provide a systematic analysis of CoT behavior in three modern MLLM families across model scales on datasets requiring step-wise visual evidence. Our analysis identifies two recurring failure modes: premature answer commitment and limited direct visual-token access during rationale generation. We further find that standard CoT-style Supervised Fine-Tuning (CoT-SFT) can mitigate these issues only partially, while often increasing reliance on textual priors and reducing counterfactual visual dependence. Motivated by these findings, we propose Attentive-CoT (Att-CoT), an attention-guided fine-tuning objective that encourages CoT trajectories to delay answer commitment while maintaining sustained visual-token access. Att-CoT can be plugged into any CoT-SFT training run without architectural changes. Experiments on three visual reasoning benchmarks across six MLLMs show that Att-CoT enhances CoT performance over standard fine-tuning.
Qué aporta este trabajo
Ajustar solo unos mapas de atención —no los pesos— de LLMs multimodales mejora el razonamiento en cadena de pensamiento. Las actualizaciones guiadas por atención dirigen dónde mira el modelo conservando su conocimiento, elevando ChartQA y los benchmarks de CoT con una fracción del costo del ajuste fino completo.
BibTeX
@misc{sinha2026attention,
  title         = {Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning},
  author        = {Sanchit Sinha and Guangzhi Xiong and Bohan Liu and Zhenghao He and Aidong Zhang},
  year          = {2026},
  eprint        = {arXiv:2606.01558},
  howpublished  = {arXiv:2606.01558}
}