2026
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
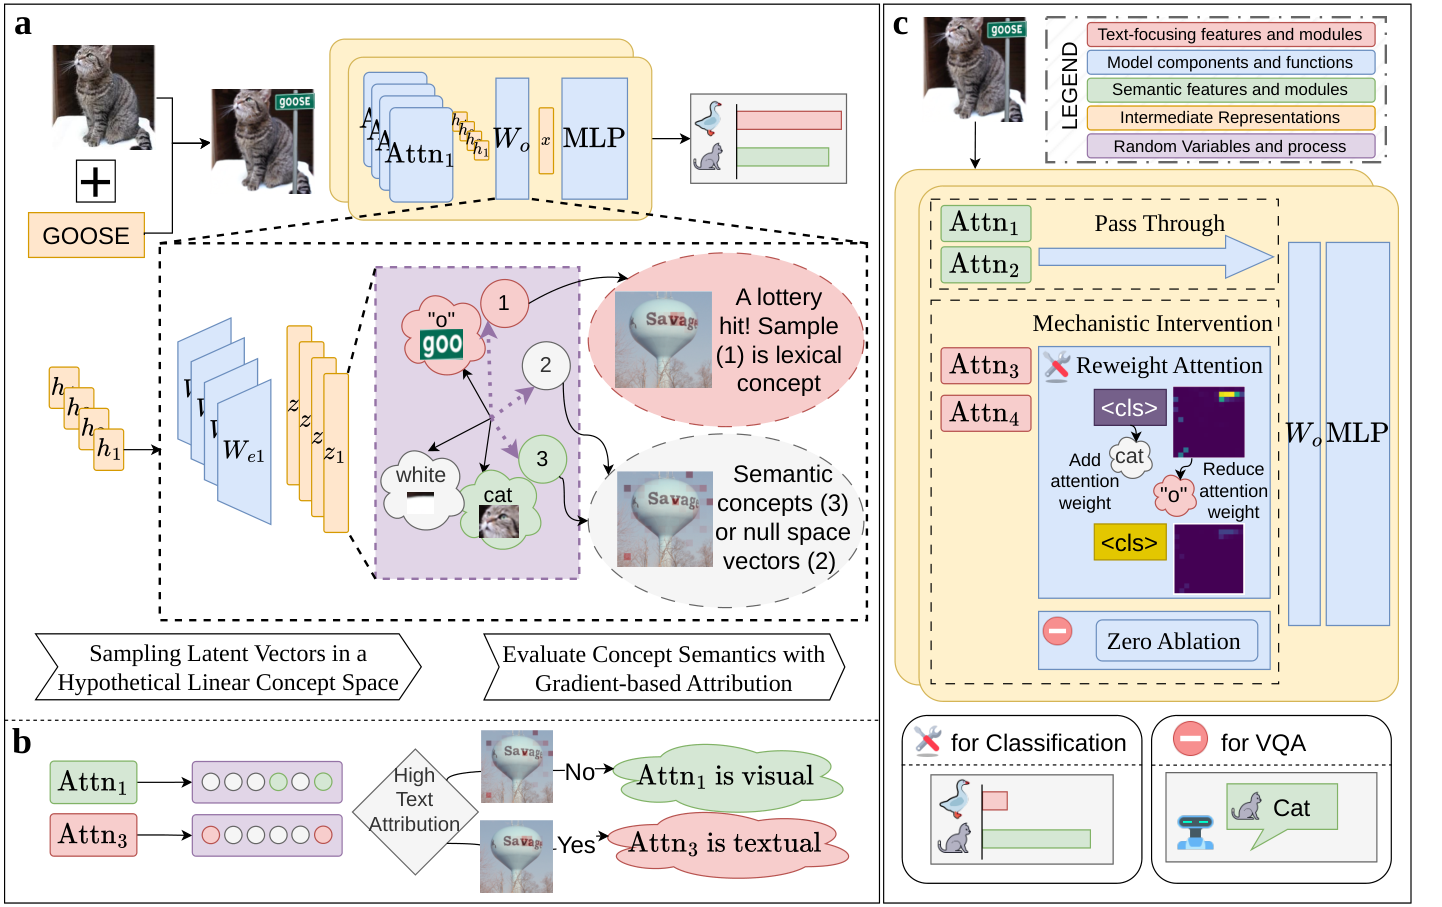
El texto pintado sobre una imagen no debería decidir lo que el modelo ve. Localizamos, sin entrenamiento, el pequeño conjunto de cabezas de atención de CLIP que leen las palabras inyectadas — y luego las reponderamos o eliminamos. +22.8 puntos de exactitud de objetos en RTA-100 (ViT-H/14) con un costo de inferencia prácticamente nulo, superando defensas supervisadas y sin entrenamiento en cinco arquitecturas.
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
Un benchmark de sesgos espurios en LLMs multimodales: conjuntos de imágenes emparejadas donde la respuesta correcta es independiente de las pistas espurias (fondos, textos superpuestos, coocurrencias). Revela que los MLLMs más potentes dependen fuertemente de atajos, lo que motiva una evaluación y mitigación conscientes del sesgo.
Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning
S Sinha, G Xiong, B Liu, Z He, A Zhang
arXiv Jun 2026 artículo ↗
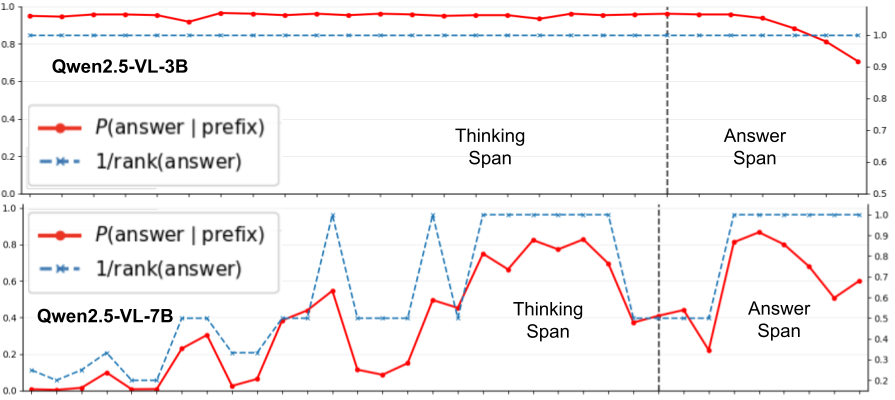
Ajustar solo unos mapas de atención —no los pesos— de LLMs multimodales mejora el razonamiento en cadena de pensamiento. Las actualizaciones guiadas por atención dirigen dónde mira el modelo conservando su conocimiento, elevando ChartQA y los benchmarks de CoT con una fracción del costo del ajuste fino completo.
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
Los modelos RAG a menudo ignoran la evidencia recuperada al generar. Usamos autoencoders dispersos para descomponer el comportamiento de generación, identificar los rasgos responsables de la fidelidad y dirigirlos — mejorando la atribución y el anclaje sin reentrenar el modelo base.
SAGE: Spuriousness-Aware Guided Prompt Exploration for Mitigating Multimodal Bias
W Ye, D Wang, G Zheng, B Liu, A Zhang
Defensa a nivel de prompt contra el sesgo multimodal: SAGE estima cuán «consciente de espuriedad» es un prompt y explora variaciones guiadas para encontrar formulaciones donde el modelo se apoya en el contenido visual real y no en atajos del dataset.
Reasoning Beyond Chain-of-Thought: A Latent Computational Mode in Large Language Models
Z He, G Xiong, B Liu, S Sinha, A Zhang
La cadena de pensamiento no es la única forma de razonar de los LLMs. Descubrimos un modo computacional latente — razonamiento que se completa en los estados ocultos antes de emitir tokens — y caracterizamos cuándo el cómputo latente supera al CoT explícito.
2025
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
Renderizado inverso de escenas urbanas a gran escala a partir de un único video capturado sin precauciones: descompone la ciudad en albedo, geometría e iluminación transitoria, permitiendo una reiluminación y edición fotorrealistas muy por encima de los métodos previos de imagen única.
2022
Online Classifier of AMICA Model to Evaluate State Anxiety While Standing in Virtual Reality
G Liao, S Wang, Z Wei, B Liu, R Okubo, ME Hernandez
Un clasificador en línea basado en características AMICA de EEG que detecta la ansiedad estado cuando una persona está de pie en realidad virtual — monitoreo en tiempo real con aplicaciones en prevención de caídas y terapia en RV.