Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning
Sanchit Sinha, Guangzhi Xiong, Bohan Liu, Zhenghao He, Aidong Zhang
Résumé
Resume traduit automatiquement a partir de la version anglaise originale.
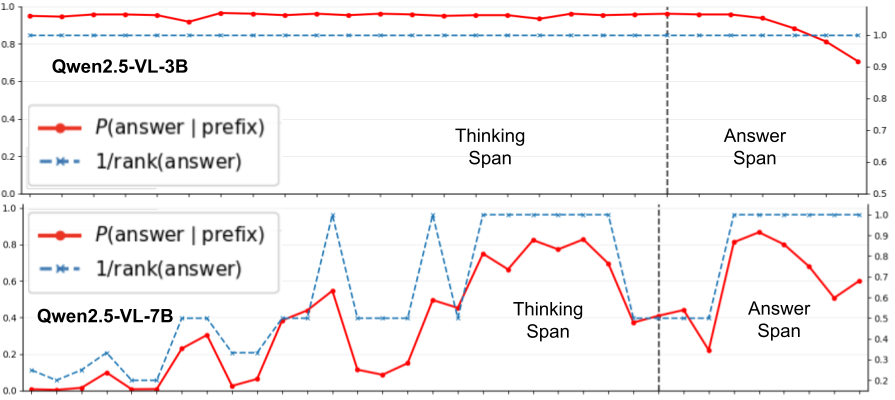
L'efficacité du prompting par chaîne-de-pensée (CoT) dans les grands modèles de langage multimodaux (MLLM) reste incertaine : sur plusieurs référentiels de raisonnement visuel, le prompting CoT dégrade souvent les performances par rapport au prompting direct. Dans cet article, nous fournissons une analyse systématique du comportement CoT dans trois familles modernes de MLLM à travers les échelles de modèles, sur des jeux de données nécessitant des preuves visuelles étape par étape. Notre analyse identifie deux modes de défaillance récurrents : l'engagement prématuré dans la réponse et un accès limité aux tokens visuels directs pendant la génération des justifications. Nous trouvons en outre que le fine-tuning supervisé de style CoT standard (CoT-SFT) ne résout ces problèmes que partiellement, tout en augmentant souvent la dépendance aux priors textuels et en réduisant la dépendance visuelle contrefactuelle. Motivés par ces résultats, nous proposons Attentive-CoT (Att-CoT), un objectif de fine-tuning guidé par l'attention qui encourage les trajectoires CoT à retarder l'engagement dans la réponse tout en maintenant un accès soutenu aux tokens visuels. Att-CoT peut être branché dans tout entraînement CoT-SFT sans changement architectural. Des expériences sur trois référentiels de raisonnement visuel et six MLLM montrent qu'Att-CoT améliore les performances CoT par rapport au fine-tuning standard.
Resume original (anglais)
The effectiveness of Chain-of-Thought (CoT) prompting in Multimodal Large Language Models (MLLMs) remains uncertain: across several visual reasoning benchmarks, CoT prompting often degrades performance compared to direct prompting. In this paper, we provide a systematic analysis of CoT behavior in three modern MLLM families across model scales on datasets requiring step-wise visual evidence. Our analysis identifies two recurring failure modes: premature answer commitment and limited direct visual-token access during rationale generation. We further find that standard CoT-style Supervised Fine-Tuning (CoT-SFT) can mitigate these issues only partially, while often increasing reliance on textual priors and reducing counterfactual visual dependence. Motivated by these findings, we propose Attentive-CoT (Att-CoT), an attention-guided fine-tuning objective that encourages CoT trajectories to delay answer commitment while maintaining sustained visual-token access. Att-CoT can be plugged into any CoT-SFT training run without architectural changes. Experiments on three visual reasoning benchmarks across six MLLMs show that Att-CoT enhances CoT performance over standard fine-tuning.
Ce que cet article apporte
Affiner seulement quelques cartes d'attention — pas les poids — de LLM multimodaux améliore le raisonnement chaîne-de-pensée. Les mises à jour guidées par l'attention dirigent le regard du modèle tout en préservant ses connaissances, améliorant ChartQA et les benchmarks CoT pour une fraction du coût d'un affinage complet.
BibTeX
@misc{sinha2026attention,
  title         = {Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning},
  author        = {Sanchit Sinha and Guangzhi Xiong and Bohan Liu and Zhenghao He and Aidong Zhang},
  year          = {2026},
  eprint        = {arXiv:2606.01558},
  howpublished  = {arXiv:2606.01558}
}