Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
ECCV 2026 arXiv ↗ proyecto ↗ Scholar ↗
Resumen
Resumen traducido automaticamente a partir del original en ingles.
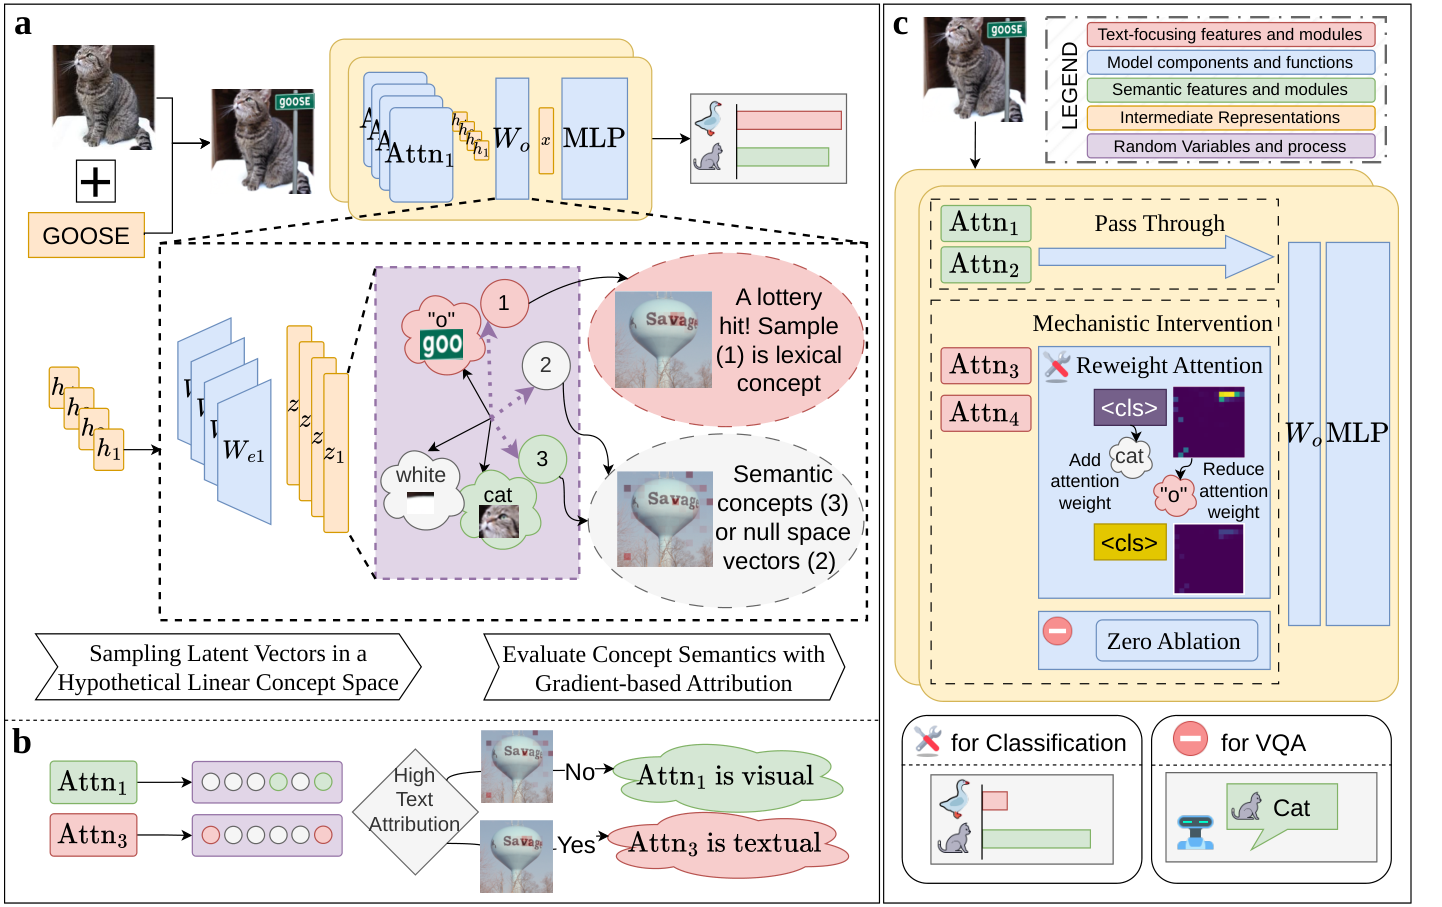
Los modelos entrenados mediante Contrastive Language-Image Pretraining (CLIP) sirven como codificadores visuales fundamentales para la mayoría de los grandes modelos de lenguaje y visión (LVLM) modernos. A pesar de su amplia adopción, los modelos CLIP exhiben un modo de fallo crítico y poco explorado: el texto irrelevante que aparece dentro de las imágenes confunde las representaciones visuales, sesgándolas hacia el significado léxico en lugar de la semántica visual real. Este problema de robustez, comúnmente descrito como Typographic Attack (TA), expone una vulnerabilidad que supone un riesgo significativo para aplicaciones críticas para la seguridad, como la conducción autónoma. Para lograr una robustez interpretable y eficaz frente a los TA, proponemos un novedoso método de interpretabilidad mecanicista sin entrenamiento. Nuestro método proporciona interpretaciones basadas en muestreo de las representaciones de estado oculto y atribuye cuantitativamente el foco semántico frente al léxico a cabezas de atención individuales. Mediante análisis probabilístico y minería de circuitos, aislamos componentes específicos del Vision Transformer (ViT) que codifican desproporcionadamente información léxica, identificando así la fuente mecanicista de los TA. Demostramos además que intervenciones simples aplicadas directamente a los circuitos identificados, sin ningún entrenamiento adicional, mejoran sustancialmente la robustez frente a los TA en clasificación de objetos. Estas intervenciones, como el ajuste selectivo de pesos de atención, superan tanto a los métodos de defensa supervisados como a los que no requieren entrenamiento. Nuestros experimentos demuestran que aplicar la intervención propuesta a los codificadores visuales de varios LVLM del estado del arte produce ganancias sustanciales en precisión de Visual Question Answering bajo interferencia de TA en RIO-Bench. Estos resultados confirman tanto la eficacia como la generalizabilidad de nuestro enfoque mecanicista. El código se publica en https://github.com/Liu-524/SamplingTAR.
Resumen original (ingles)
Models trained via Contrastive Language-Image Pretraining (CLIP) serve as the foundational vision encoders for most modern Large Vision Language Models (LVLMs). Despite their widespread adoption, CLIP models exhibit a critical yet underexplored failure mode: irrelevant text appearing within images confounds visual representations, biasing them toward lexical meaning rather than true visual semantics. This robustness issue, commonly described as a Typographic Attack (TA), exposes a vulnerability that poses a significant risk to safety-critical applications such as autonomous driving. To achieve interpretable and effective robustness against TA, we propose a novel, training-free mechanistic interpretability method. Our method provides sampling-based interpretations of hidden state representations and quantitatively attributes semantic versus lexical focus to individual attention heads. Through probabilistic analysis and circuit mining, we isolate specific Vision Transformer (ViT) components that disproportionately encode lexical information, thereby identifying the mechanistic source of TA. We further show that simple interventions applied directly to the identified circuits, without any additional training, can substantially improve robustness against Typographic Attacks in object classification. These interventions, such as selective adjustment of attention weights, also outperform both supervised and training-free defense methods. Our experiments demonstrate that applying the proposed intervention to the vision encoders of several state-of-the-art LVLMs yields substantial gains in Visual Question Answering accuracy under Typographic Attack interference on RIO-Bench. These results confirm both the efficacy and the generalizability of our mechanistic approach. Code is released at https://github.com/Liu-524/SamplingTAR.
Qué aporta este trabajo
El texto pintado sobre una imagen no debería decidir lo que el modelo ve. Localizamos, sin entrenamiento, el pequeño conjunto de cabezas de atención de CLIP que leen las palabras inyectadas — y luego las reponderamos o eliminamos. +22.8 puntos de exactitud de objetos en RTA-100 (ViT-H/14) con un costo de inferencia prácticamente nulo, superando defensas supervisadas y sin entrenamiento en cinco arquitecturas.
BibTeX
@inproceedings{liu2026typographic,
  title     = {Towards Robustness against Typographic Attack with Training-free Concept Localization},
  author    = {Bohan Liu and Wenqian Ye and Guangzhi Xiong and Zhenghao He and Sanchit Sinha and Aidong Zhang},
  booktitle = {European Conference on Computer Vision (ECCV)},
  year      = {2026},
  url       = {https://arxiv.org/abs/2607.02494}
}