Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
ECCV 2026 arXiv ↗ projet ↗ Scholar ↗
Résumé
Resume traduit automatiquement a partir de la version anglaise originale.
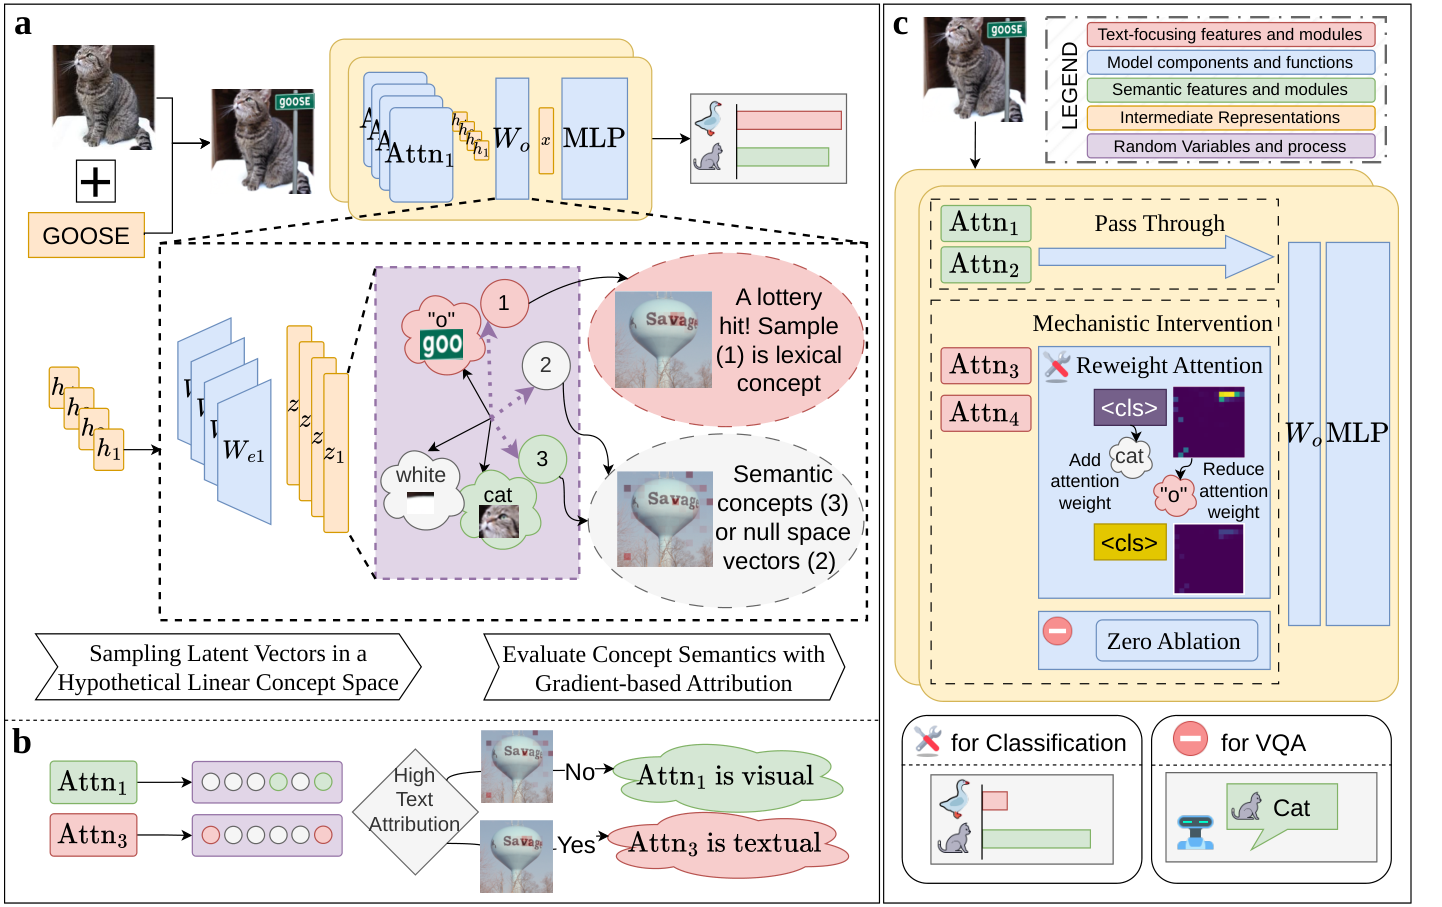
Les modèles entraînés par Contrastive Language-Image Pretraining (CLIP) servent d'encodeurs visuels fondamentaux pour la plupart des grands modèles de vision-langage (LVLM) modernes. Malgré leur adoption généralisée, les modèles CLIP présentent un mode de défaillance critique et sous-exploré : du texte non pertinent apparaissant dans les images confond les représentations visuelles, les biaisant vers le sens lexical plutôt que vers la sémantique visuelle réelle. Ce problème de robustesse, couramment décrit comme une attaque typographique (Typographic Attack, TA), expose une vulnérabilité qui pose un risque significatif pour des applications critiques pour la sécurité, comme la conduite autonome. Pour parvenir à une robustesse interprétable et efficace contre les TA, nous proposons une nouvelle méthode d'interprétabilité mécaniste sans apprentissage. Notre méthode fournit des interprétations par échantillonnage des représentations d'états cachés et attribue quantitativement le focus sémantique par rapport au focus lexical à des têtes d'attention individuelles. Par une analyse probabiliste et la découverte de circuits, nous isolons des composants spécifiques du Vision Transformer (ViT) qui encodent de manière disproportionnée de l'information lexicale, identifiant ainsi la source mécaniste des TA. Nous montrons en outre que des interventions simples appliquées directement aux circuits identifiés, sans aucun apprentissage supplémentaire, améliorent substantiellement la robustesse contre les attaques typographiques en classification d'objets. Ces interventions, comme l'ajustement sélectif des poids d'attention, surpassent à la fois les méthodes de défense supervisées et sans apprentissage. Nos expériences démontrent qu'appliquer l'intervention proposée aux encodeurs visuels de plusieurs LVLM de pointe produit des gains substantiels de précision en Visual Question Answering sous interférence de TA sur RIO-Bench. Ces résultats confirment à la fois l'efficacité et la généralisabilité de notre approche mécaniste. Le code est publié sur https://github.com/Liu-524/SamplingTAR.
Resume original (anglais)
Models trained via Contrastive Language-Image Pretraining (CLIP) serve as the foundational vision encoders for most modern Large Vision Language Models (LVLMs). Despite their widespread adoption, CLIP models exhibit a critical yet underexplored failure mode: irrelevant text appearing within images confounds visual representations, biasing them toward lexical meaning rather than true visual semantics. This robustness issue, commonly described as a Typographic Attack (TA), exposes a vulnerability that poses a significant risk to safety-critical applications such as autonomous driving. To achieve interpretable and effective robustness against TA, we propose a novel, training-free mechanistic interpretability method. Our method provides sampling-based interpretations of hidden state representations and quantitatively attributes semantic versus lexical focus to individual attention heads. Through probabilistic analysis and circuit mining, we isolate specific Vision Transformer (ViT) components that disproportionately encode lexical information, thereby identifying the mechanistic source of TA. We further show that simple interventions applied directly to the identified circuits, without any additional training, can substantially improve robustness against Typographic Attacks in object classification. These interventions, such as selective adjustment of attention weights, also outperform both supervised and training-free defense methods. Our experiments demonstrate that applying the proposed intervention to the vision encoders of several state-of-the-art LVLMs yields substantial gains in Visual Question Answering accuracy under Typographic Attack interference on RIO-Bench. These results confirm both the efficacy and the generalizability of our mechanistic approach. Code is released at https://github.com/Liu-524/SamplingTAR.
Ce que cet article apporte
Le texte peint sur une image ne devrait pas décider de ce que le modèle voit. Nous localisons, sans apprentissage, le petit ensemble de têtes d'attention de CLIP qui lisent les mots injectés — puis les repondérons ou les ablations. +22,8 points de précision d'objets sur RTA-100 (ViT-H/14) pour un coût d'inférence quasi nul, surpassant les défenses supervisées et sans apprentissage sur cinq architectures.
BibTeX
@inproceedings{liu2026typographic,
  title     = {Towards Robustness against Typographic Attack with Training-free Concept Localization},
  author    = {Bohan Liu and Wenqian Ye and Guangzhi Xiong and Zhenghao He and Sanchit Sinha and Aidong Zhang},
  booktitle = {European Conference on Computer Vision (ECCV)},
  year      = {2026},
  url       = {https://arxiv.org/abs/2607.02494}
}