Triggering Chain-of-Thought via Latent Feature Interventions in Large Language Models
Zhenghao He, Guangzhi Xiong, Bohan Liu, Sanchit Sinha, Aidong Zhang
Resumen
Resumen traducido automaticamente a partir del original en ingles.
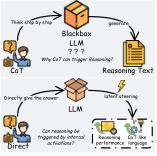
El prompting con cadena de pensamiento (CoT) a menudo mejora el rendimiento de razonamiento de los grandes modelos de lenguaje (LLM), pero la señal interna que desencadena este comportamiento sigue sin comprenderse bien. Aprovechando las características dispersas capturadas por autoencoders dispersos (SAE), proponemos un marco sistemático para analizar e intervenir sobre las representaciones internas de los LLM, identificando un pequeño conjunto de características latentes vinculadas al comportamiento de razonamiento que pueden someterse a pruebas causales mediante intervención dirigida. A través de múltiples familias de modelos y benchmarks de razonamiento, mostramos que dirigir una o un pequeño número de características latentes relacionadas con el razonamiento puede inducir sustancialmente comportamiento de razonamiento sin prompting CoT explícito, alcanzando una precisión comparable a la del CoT. Mostramos además que las características identificadas no están ligadas a patrones de redacción ni a la verbosidad, y confirmamos su papel causal en el razonamiento mediante experimentos de supresión que deterioran el rendimiento incluso con prompting CoT. Estos resultados sugieren que el prompting CoT activa características latentes específicas para desencadenar el razonamiento, y que la intervención dirigida sobre estas características ofrece una vía alternativa para elicitar comportamiento de razonamiento eficiente sin prompting CoT explícito. El código está disponible en https://github.com/Zhenghao-He/LatentCoT.
Resumen original (ingles)
Chain-of-Thought (CoT) prompting often improves the reasoning performance of large language models (LLMs), but the internal signal that triggers this behavior remains poorly understood. Leveraging the sparse features captured by Sparse Autoencoders (SAEs), we propose a systematic framework to analyze and intervene on the internal representations of LLMs, identifying a small set of latent features that are linked to reasoning behavior and can be causally tested through targeted intervention. Across multiple model families and reasoning benchmarks, we show that steering one or a small number of reasoning-related latent features can substantially induce reasoning behavior without explicit CoT prompting, achieving accuracy comparable to CoT. We further show that the identified features are not tied to particular wording patterns or verbosity, and confirm their causal role in reasoning through suppression experiments that impair performance even under CoT prompting. These results suggest that CoT prompting activates specific latent features to trigger reasoning, and that targeted intervention on these features offers an alternative pathway to elicit efficient reasoning behavior without explicit CoT prompting. Code is available at https://github.com/Zhenghao-He/LatentCoT.
Qué aporta este trabajo
La cadena de pensamiento no es la única forma de razonar de los LLMs. Descubrimos un modo computacional latente — razonamiento que se completa en los estados ocultos antes de emitir tokens — y caracterizamos cuándo el cómputo latente supera al CoT explícito.
BibTeX
@misc{he2026latent,
  title         = {Triggering Chain-of-Thought via Latent Feature Interventions in Large Language Models},
  author        = {Zhenghao He and Guangzhi Xiong and Bohan Liu and Sanchit Sinha and Aidong Zhang},
  year          = {2026},
  eprint        = {arXiv:2601.08058},
  howpublished  = {arXiv:2601.08058}
}