Triggering Chain-of-Thought via Latent Feature Interventions in Large Language Models
Zhenghao He, Guangzhi Xiong, Bohan Liu, Sanchit Sinha, Aidong Zhang
Résumé
Resume traduit automatiquement a partir de la version anglaise originale.
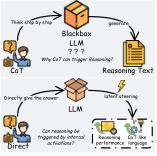
Le prompting par chaîne-de-pensée (CoT) améliore souvent les performances de raisonnement des grands modèles de langage (LLM), mais le signal interne déclenchant ce comportement demeure mal compris. En exploitant les caractéristiques parcimonieuses capturées par les autoencodeurs parcimonieux (SAE), nous proposons un cadre systématique pour analyser et intervenir sur les représentations internes des LLM, identifiant un petit ensemble de caractéristiques latentes liées au comportement de raisonnement et testables causalement par intervention ciblée. À travers plusieurs familles de modèles et référentiels de raisonnement, nous montrons que diriger une ou un petit nombre de caractéristiques latentes liées au raisonnement peut induire substantiellement un comportement de raisonnement sans prompting CoT explicite, atteignant une précision comparable au CoT. Nous montrons en outre que les caractéristiques identifiées ne sont pas liées à des motifs de formulation ni à la verbosité, et confirmons leur rôle causal dans le raisonnement par des expériences de suppression qui dégradent les performances même avec prompting CoT. Ces résultats suggèrent que le prompting CoT active des caractéristiques latentes spécifiques pour déclencher le raisonnement, et que l'intervention ciblée sur ces caractéristiques offre une voie alternative pour susciter un comportement de raisonnement efficace sans prompting CoT explicite. Le code est disponible sur https://github.com/Zhenghao-He/LatentCoT.
Resume original (anglais)
Chain-of-Thought (CoT) prompting often improves the reasoning performance of large language models (LLMs), but the internal signal that triggers this behavior remains poorly understood. Leveraging the sparse features captured by Sparse Autoencoders (SAEs), we propose a systematic framework to analyze and intervene on the internal representations of LLMs, identifying a small set of latent features that are linked to reasoning behavior and can be causally tested through targeted intervention. Across multiple model families and reasoning benchmarks, we show that steering one or a small number of reasoning-related latent features can substantially induce reasoning behavior without explicit CoT prompting, achieving accuracy comparable to CoT. We further show that the identified features are not tied to particular wording patterns or verbosity, and confirm their causal role in reasoning through suppression experiments that impair performance even under CoT prompting. These results suggest that CoT prompting activates specific latent features to trigger reasoning, and that targeted intervention on these features offers an alternative pathway to elicit efficient reasoning behavior without explicit CoT prompting. Code is available at https://github.com/Zhenghao-He/LatentCoT.
Ce que cet article apporte
La chaîne-de-pensée n'est pas la seule façon de raisonner des LLM. Nous mettons en évidence un mode de calcul latent — un raisonnement qui s'achève dans les états cachés avant toute émission de tokens — et caractérisons quand le calcul latent surpasse le CoT explicite.
BibTeX
@misc{he2026latent,
  title         = {Triggering Chain-of-Thought via Latent Feature Interventions in Large Language Models},
  author        = {Zhenghao He and Guangzhi Xiong and Bohan Liu and Sanchit Sinha and Aidong Zhang},
  year          = {2026},
  eprint        = {arXiv:2601.08058},
  howpublished  = {arXiv:2601.08058}
}