
關於我
我是維吉尼亞大學電腦科學系博士研究生,指導教授為Aidong Zhang。我的研究涵蓋視覺、語言與穩健性——特別是理解並緩解多模態大型語言模型中的虛假偏誤,以及利用稀疏自編碼器使模型內部可解釋且忠實。我與UVA、UIUC、Georgia Tech、Waymo及Amazon AGI的研究人員密切合作。
在UVA之前,我於 伊利諾大學香檳分校取得學士與電腦科學碩士學位,並獲頒Bronze Tablet獎 (見實體獎牌; 獎牌位置)。 大學部期間,我隨Shenlong Wang教授的團隊(UrbanIR)研究都市場景逆渲染,並與Illinois Space Grant Consortium合作研究混合實境結構監測。
研究興趣
再次點擊標籤即可關閉
⚡ 想在自己的網站上使用這些動畫?請見 Concept Canvas —— 393個運算概念,兩行程式碼即可嵌入。
精選著作
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
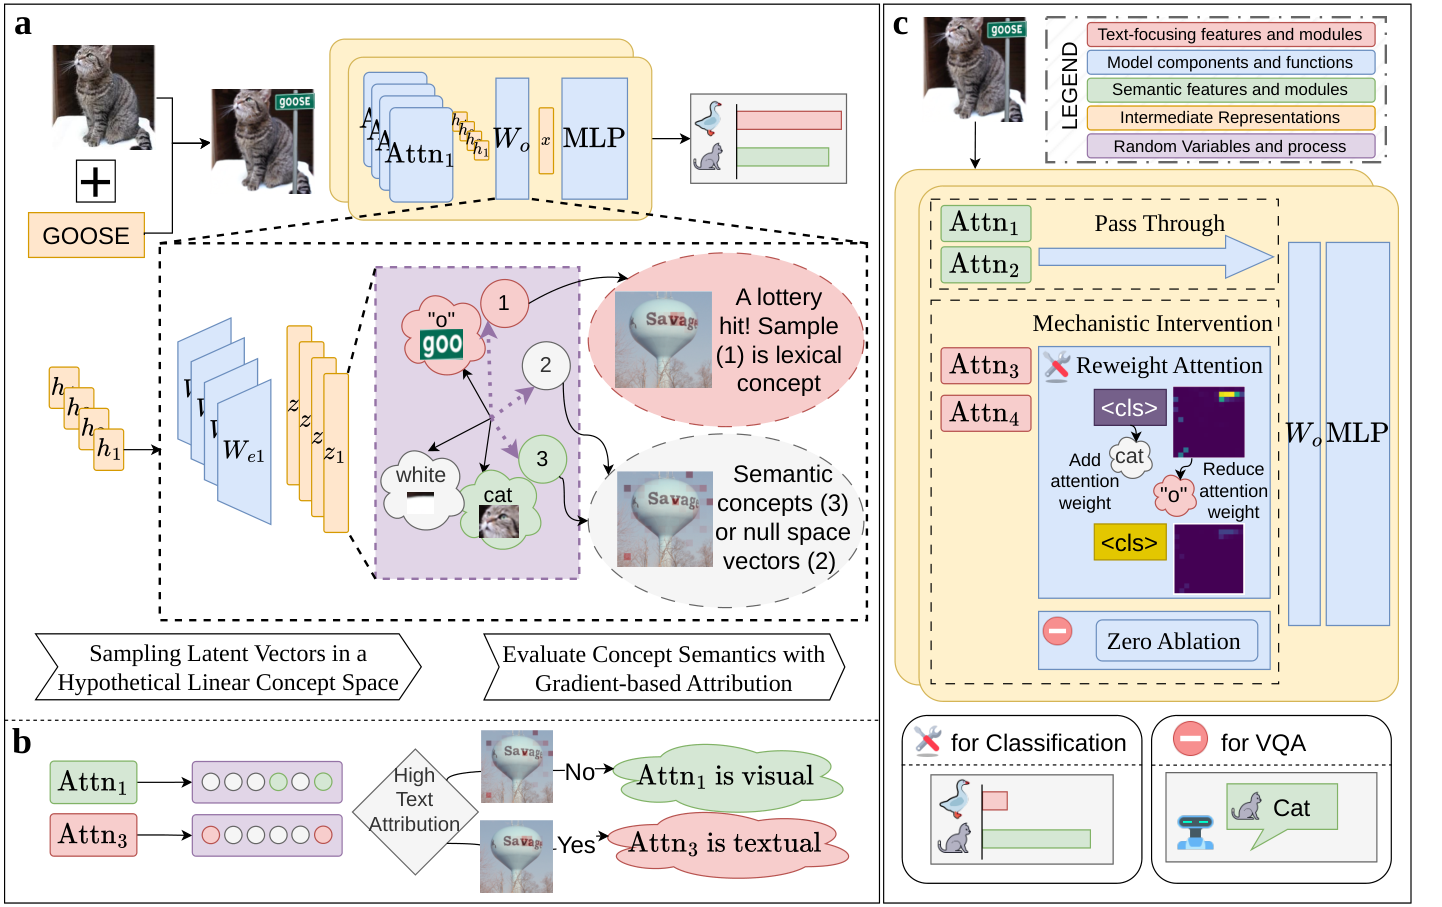
畫在圖片上的文字不應決定模型看到什麼。我們免訓練地定位出讀取注入文字的少量CLIP注意力頭,並對其重新加權或消融。在RTA-100(ViT-H/14)上物件準確率提升22.8分,測試成本趨近於零,在五種主幹網路上超越監督式與免訓練防禦。
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
多模態LLM虛假偏誤基準測試:成對影像集使正確答案與虛假線索(背景、文字覆蓋、共現)無關。結果顯示強大的MLLM嚴重依賴捷徑,促使具偏誤意識的評估與緩解。
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
RAG模型生成時常忽略檢索到的證據。我們利用稀疏自編碼器分解生成行為,找出影響忠實性的特徵並加以導引——無需重新訓練基礎模型即可改善歸因與依據。
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
從單段隨手拍攝的影片進行大規模都市場景逆渲染:將城市分解為反照率、幾何與瞬態光照,實現遠超以往單張影像方法的擬真重光照與編輯。
完整清單請見研究著作頁與 Google Scholar.
學術服務
工作坊
同儕審查
審查者 · NeurIPS · 2026
審查者 · AAAI · 2027
教學與指導
助教 · CS 415 遊戲開發, CS 410 文字資訊系統 · UIUC 2023–24
課程助理 · CS 125 計算機科學導論 · UIUC 2020
導師 · Worldwide Youth in Science and Engineering (WYSE) · UIUC 2022